https://documentacion.onelyra.com/funcionalidades/ia/conectar-la-ia/ · Actualizado el 25 de octubre de 2026
Conectar la IA
- Qué es
- La tercera clase de conexión, junto a canales y sistemas: la clave de un proveedor de IA, cifrada, con su prueba; para qué se usa, con qué modelo; y lo que gasta.
- Para quién
- Quien administra las conexiones.
- Dónde vive
- En Conexiones › Inteligencia.
La IA es una conexión más, como un canal o un sistema: tiene una credencial, se prueba y tiene un estado. Se conecta en Conexiones › Inteligencia. El gasto es con el proveedor: la organización pega su propia clave y paga su consumo directamente.
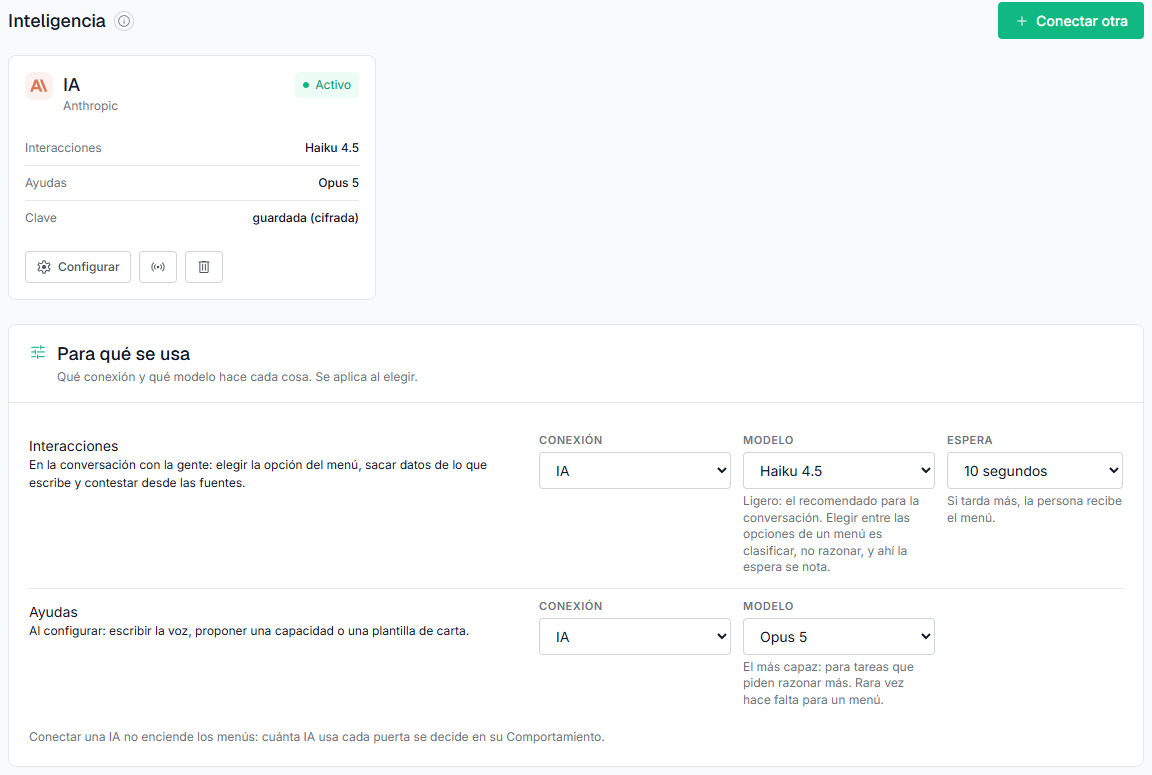
La pantalla tiene tres partes: las conexiones (la clave de cada proveedor), para qué se usa (qué conexión y qué modelo hace cada cosa) y el consumo (cuántos tokens gasta cada modelo en cada uso).
Las conexiones
Sección titulada «Las conexiones»Una conexión es un proveedor y su clave. La clave se pega una sola vez aunque se usen varios modelos de ese proveedor: en todos los proveedores una misma clave sirve para todos sus modelos, y el modelo se elige en cada uso.
| Campo | Qué es |
|---|---|
| Nombre | Para distinguirla de las demás conexiones. Dos no pueden llamarse igual. |
| Clave | La da el proveedor, en la sección de claves de su consola. Se guarda cifrada y no se vuelve a mostrar a nadie, ni a quien la pegó. Para cambiar el nombre sin tocar la clave, se deja vacía. |
La lista de proveedores sale en el formulario de conectar; cada proveedor trae sus propios modelos.
Varias conexiones sirven para dos cosas: usar proveedores distintos, o usar dos claves del mismo proveedor para que su gasto se facture aparte (los proveedores permiten crear claves por proyecto o por espacio de trabajo). Para cambiar de modelo no hace falta otra conexión.
Para qué se usa
Sección titulada «Para qué se usa»Debajo de las conexiones hay tres pestañas: Para qué se usa, Consumo y Qué ha hecho en la conversación. Al entrar están cerradas; cada una se abre al pulsarla y se cierra pulsándola otra vez.
En Para qué se usa hay una fila por uso. En cada una se elige la conexión, el modelo y, en la conversación, cuánto se la espera:
| Uso | Qué hace |
|---|---|
| Interacciones | Lo que pasa en la conversación con la gente: elegir la opción del menú cuando alguien escribe con sus palabras, sacar datos de lo que escribe, contestar desde las fuentes y probar el banco de frases de un menú. |
| Ayudas | Lo que ayuda a configurar: escribir la voz con la que se dicen los textos, proponer los bloques de una capacidad y proponer una plantilla de carta. |
| EFEMERIS | Contestar las preguntas del auditor en EFEMERIS, buscando en la evidencia, con una cifra y un enlace por cada cosa que afirma. Ver El asistente de EFEMERIS. |
Léalo así: cada uso lo hace una sola conexión con un solo modelo, así que siempre se sabe cuál contestó. Una misma conexión puede hacer la conversación con un modelo y las ayudas con otro.
Cada proveedor ofrece varios modelos, del más ligero al más capaz. La lista de cada fila trae los del proveedor de esa conexión, y debajo una pista de para qué sirve el elegido. Para escoger, sirve esta regla:
| Tipo de modelo | Cuándo |
|---|---|
| Ligero | El recomendado para la conversación: es el más rápido, y elegir entre las opciones de un menú es clasificar, no razonar. Ahí la espera se nota. |
| Intermedio | Más capaz. Conviene si, al medir con el banco de frases, el ligero falla con las frases de la gente. |
| El más capaz | Para tareas que piden razonar más. Rara vez hace falta para un menú. |
El precio de cada modelo lo fija el proveedor y está en su página de precios. Con los tokens de la tarjeta de consumo y esa tarifa se calcula cuánto cuesta cada uso.
La espera solo se decide en Interacciones, que es donde alguien aguarda la respuesta: 2, 4, 6 o 10 segundos, y si tarda más, la persona recibe el menú de siempre. Lo que ayuda a configurar trae su propia espera por tarea, porque quien configura sí puede esperar.
La primera conexión hace todos los usos con el modelo ligero de su proveedor. Las siguientes no hacen nada hasta que se eligen en una fila: una conexión nueva no le quita trabajo a otra hasta que alguien lo decide.
Un uso sin conexión se hace a mano. Sin conexión en Interacciones, los menús funcionan con sus botones y sus números, como sin IA. Sin conexión en Ayudas, la voz, las capacidades y las plantillas se escriben a mano, y los botones que las proponen no aparecen.
Elegir una conexión no enciende la IA en ninguna conversación. Cuánta IA usa cada puerta se decide en su Comportamiento (ver Los tres modos de una puerta).
El botón de probar de una conexión no comprueba solo que la dirección responda: hace una clasificación real («quiero que me atienda alguien de verdad», entre «Consultar un caso» y «Hablar con una persona») con cada modelo que esa conexión usa, y dice qué eligió y en cuánto tiempo. Se prueba cada modelo porque una clave puede no tener permiso para alguno. Si tardó más que la espera de la conversación, avisa de que en una conversación real ese turno habría caído al menú.
Cuando algo falla, el motivo se dice en palabras: se acabó el saldo, la clave no es válida, la clave no tiene permiso para ese modelo, demasiadas peticiones seguidas, o no se pudo alcanzar al proveedor.
Si la IA se desconecta o falla
Sección titulada «Si la IA se desconecta o falla»Nada se rompe. Desconectar una conexión borra su clave y deja a mano los usos que hacía, hasta que otra conexión los haga; los menús siguen funcionando como si nunca hubiera estado. Lo que gastó se queda en el consumo, con su nombre. Si en las últimas veinticuatro horas las tres últimas lecturas fallaron, el Inicio lo avisa: mientras tanto la gente ve el menú.
Lo que gasta
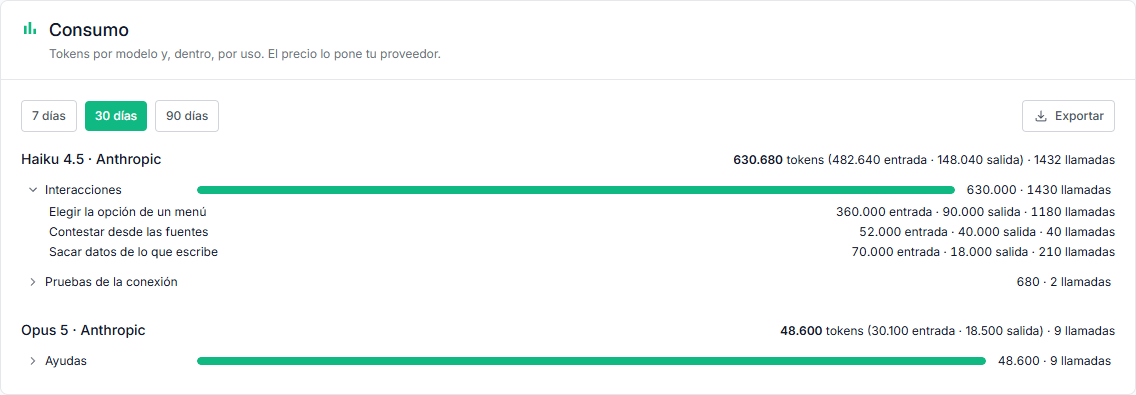
Sección titulada «Lo que gasta»Cada llamada a la IA, de cualquier uso, deja anotado cuántos tokens gastó. La pestaña Consumo los enseña por periodo (7, 30 o 90 días):
| Nivel | Qué dice |
|---|---|
| Modelo | El total de tokens del modelo, separado en entrada y salida, y cuántas llamadas hizo. |
| Uso | Dentro de cada modelo, cuánto fue de Interacciones, de Ayudas o de las pruebas de la conexión, con una barra de su parte. |
| Función | Al pulsar un uso, en qué se fue: elegir la opción de un menú, sacar datos, contestar desde las fuentes, escribir la voz, proponer una capacidad o una plantilla. |
Léalo así: «el modelo ligero gastó 10.000 tokens en el mes: 5.000 en la conversación, 3.000 ayudando a configurar…» es la cuenta que permite decidir qué modelo poner en cada uso.
Tres reglas de la cuenta:
- Entrada y salida van aparte, porque los proveedores cobran la salida varias veces más cara que la entrada.
- No se suman modelos de proveedores distintos: cada proveedor cuenta los tokens a su manera, y la misma cantidad de texto no da los mismos tokens en todos.
- Lo que el proveedor no informa se dice, en vez de contarlo como cero.
ELYRA cuenta tokens, no dinero: el precio lo pone el proveedor y lo factura él. Exportar baja cada llamada del periodo en una hoja de cálculo (cuándo, qué conexión, qué modelo, qué uso y función, cuántos tokens y cuánto tardó). Solo lleva números: nada de lo que escribió la gente.
La pestaña Qué ha hecho en la conversación cuenta lo que hizo la IA en los menús: cuántas veces leyó, cuántas llevó a una opción y cuántas dudó. El detalle está en Lo que queda de la IA.